OpenAI, Google y Microsoft implementan un sistema común para gestionar el uso de contenido en IA
Redactado con inteligencia artificial.
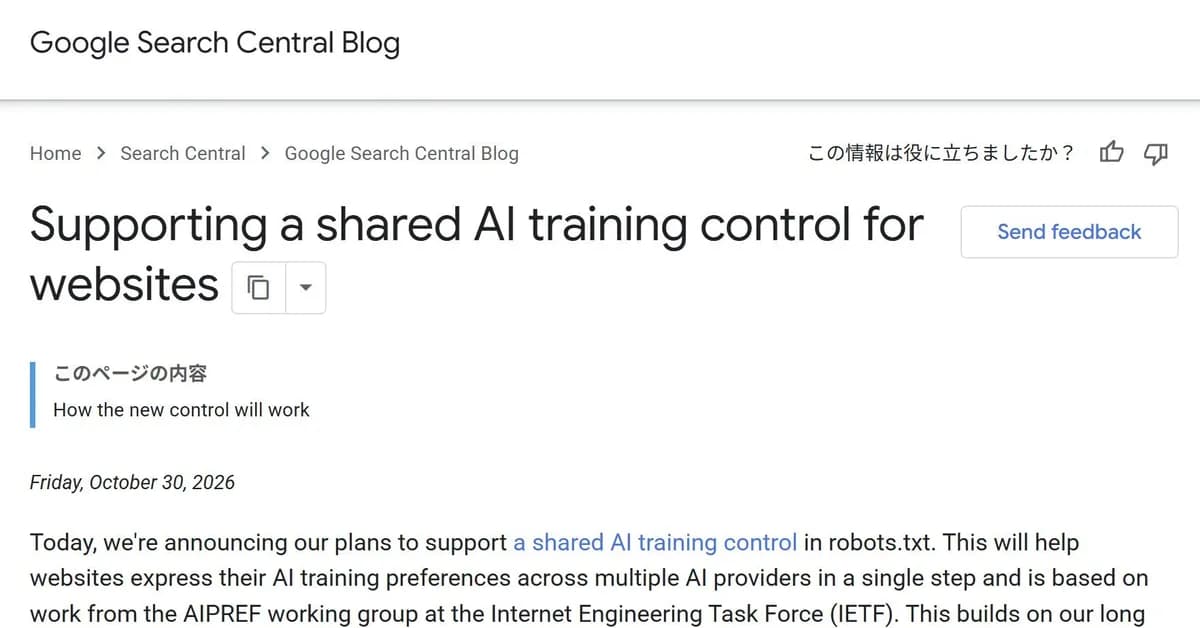
OpenAI, Google y Microsoft han anunciado su intención de adoptar un sistema común que permitirá a los propietarios de sitios web especificar su consentimiento para el uso de contenido en el aprendizaje de IA. Este sistema se basará en la adición de un token en el archivo robots.txt, facilitando así la gestión de las preferencias de contenido ante múltiples empresas de inteligencia artificial.
Nuevo sistema de gestión de contenido
El 30 de octubre, OpenAI, Google y Microsoft comunicaron que apoyarán un sistema común que permitirá a los propietarios de sitios web expresar su voluntad sobre el uso de su contenido para el aprendizaje de inteligencia artificial. Anthropic también ha comenzado a implementar esta solución. La propuesta se incluye en un borrador presentado a la IETF (Internet Engineering Task Force) por Kevin Kelly, responsable de estandarización de Anthropic.
Cómo funciona el sistema
Los propietarios de sitios web podrán incluir un token específico en el archivo robots.txt, que regula el acceso de los crawlers a sus sitios. Este nuevo mecanismo permitirá que, mediante una única señal, se pueda rechazar o permitir el uso del contenido por múltiples empresas de IA. Por ejemplo, al usar el token `__usage_ai-training`, se puede especificar que se prohíbe el uso del contenido para el aprendizaje de IA, excepto en rutas específicas.
Plazos de implementación
Las empresas tienen diferentes plazos para implementar este sistema. OpenAI espera hacerlo en los próximos meses, mientras que Google prevé que su adopción sea para 2027. Microsoft también comenzará a aplicar este sistema el 1 de febrero de 2027, permitiendo especificar preferencias a través de meta etiquetas y cabeceras HTTP, además de en robots.txt.
Contexto y consideraciones adicionales
Este desarrollo responde a las demandas de editores y grupos de interés que buscan una regulación clara sobre el uso de contenido en IA. Las empresas también han expresado que los controles específicos de cada una pueden seguir aplicándose y que esta nueva señal no reemplazará las herramientas existentes. En el contexto de litigios recientes relacionados con el uso de contenido por parte de IA, esta iniciativa podría representar un avance significativo en la regulación del uso de datos en el aprendizaje de modelos de inteligencia artificial.